欢迎光临好主题官网!致力于 WordPress 企业主题定制开发及 WP外贸模板下载。
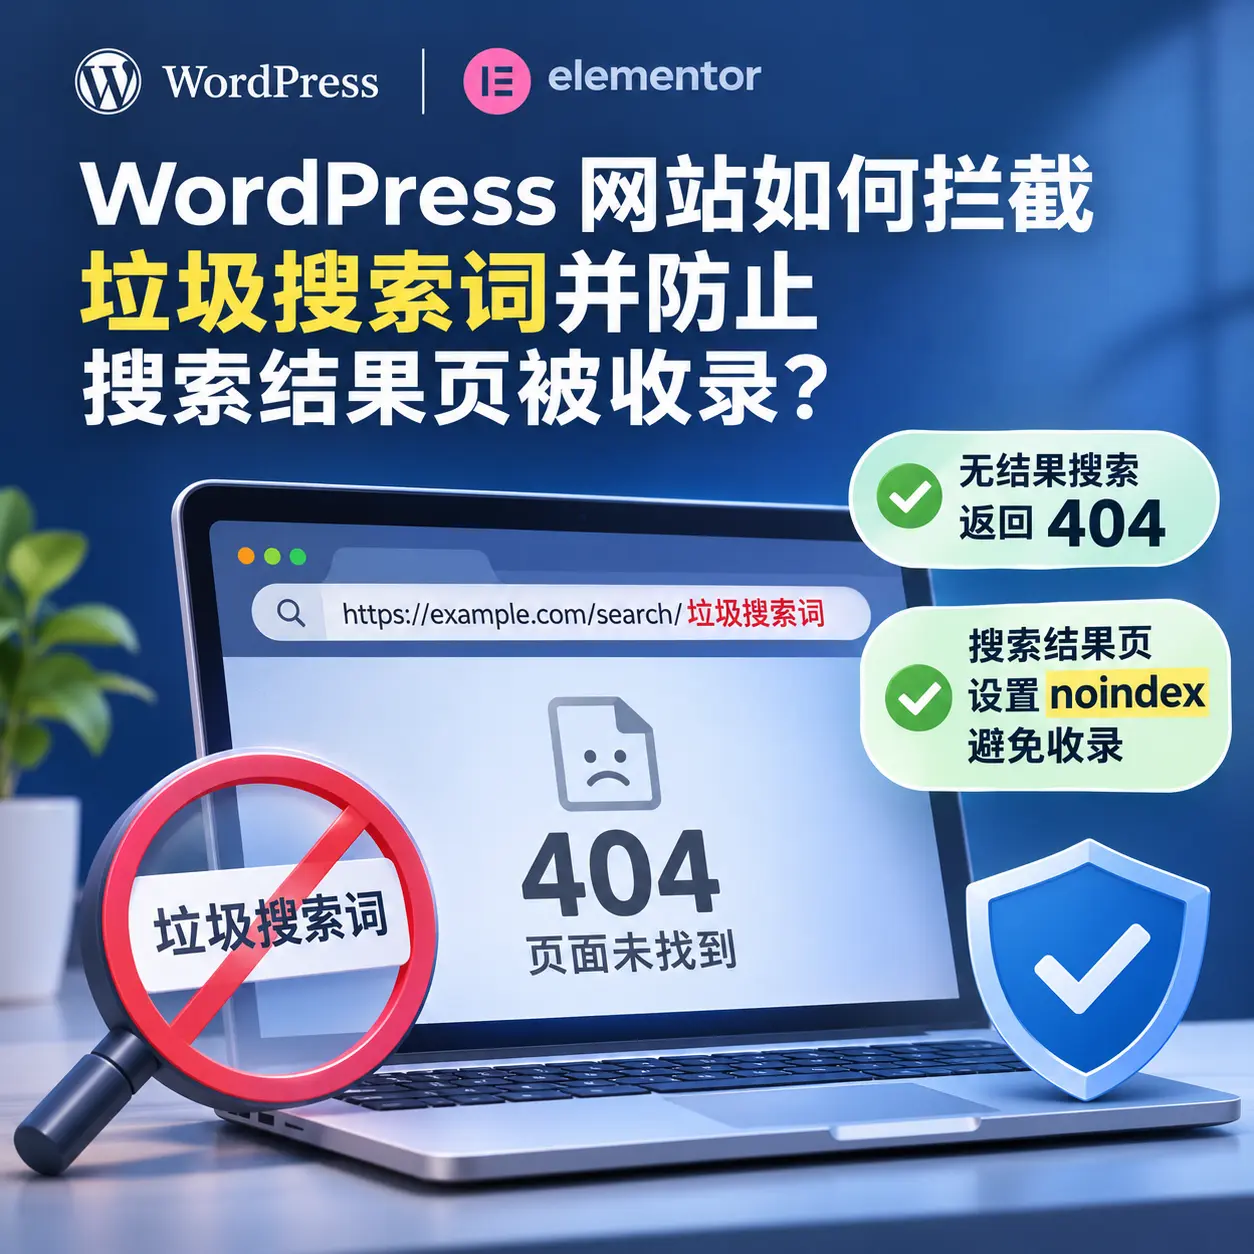
在运营 WordPress 企业网站的过程中,站长可能会发现一些异常访问:有人通过浏览器直接构造搜索 URL,将无关的推广信息、联系方式或其他垃圾搜索词拼接到网站地址后面。
例如,网站可能出现以下形式的 URL:
https://example.com/search/异常搜索词
https://example.com/?s=异常搜索词
这些 URL 可能正常访问,并生成对应的搜索结果页面。即使网站没有被入侵、文件没有被篡改,也可能面临以下问题:
针对这类情况,没有必要一开始就认定网站遭到了入侵。首先应该确认请求的实际行为,再通过 WordPress 查询控制和搜索引擎收录规则解决问题。
本文以 WordPress + Elementor 网站为例,介绍一套简单、实用的处理方案。
一种常见的解决方案是维护垃圾搜索词黑名单,例如:
$blocked_patterns = [
    '/异常词语/u',
    '/垃圾推广词/u',
    '/无关联系方式/u',
];
当搜索词匹配指定规则时,直接返回 404。
这种方式可以拦截已知的垃圾搜索词,但存在明显的局限:
因此,如果网站的主要目标是阻止没有实际搜索结果的页面继续输出,更合适的方式是直接判断 WordPress 搜索查询的结果数量。
核心思路:搜索结果为 0 时返回真正的 404;有搜索结果时正常展示页面,同时禁止搜索结果页被搜索引擎收录。
这种方式不依赖具体的垃圾搜索词,可以自动处理不断变化的无结果搜索请求。
WordPress 提供了主查询对象 WP_Query,其中的 found_posts 属性可以用于获取符合查询条件的文章总数。
当 found_posts 为 0 时,说明当前主查询没有找到符合条件的内容。
可以在主题的 functions.php 中添加以下代码,也可以放入自己维护的功能插件中。
/**
 * Haozhuti:无结果搜索页返回 404
 *
 * 适用:WordPress + Elementor
 * 规则:前台搜索结果为 0 时返回真正的 404。
 */
add_action('template_redirect', function () {
    if (is_admin() || !is_search()) {
        return;
    }

    global $wp_query;

    if (!($wp_query instanceof WP_Query)) {
        return;
    }

    // 获取当前搜索词
    $search_query = get_search_query(false);

    // 空搜索词不处理
    if (!is_string($search_query) || trim($search_query) === '') {
        return;
    }

    // 主查询没有任何结果时,返回真正的 404
    if ((int) $wp_query->found_posts === 0) {
        $wp_query->set_404();

        status_header(404);
        nocache_headers();
    }
}, 1);
1. 判断是否为搜索页面
if (is_admin() || !is_search()) {
    return;
}
只处理前台 WordPress 搜索页面,不影响后台管理以及普通文章、页面和产品详情。
需要注意,is_search() 判断的是 WordPress 是否将当前请求识别为搜索查询。对于自定义路由,必须确认它是否正确识别。
2. 获取主查询对象
global $wp_query;
通过 WordPress 的主查询对象,获取当前搜索请求的数据。
3. 判断搜索结果数量
if ((int) $wp_query->found_posts === 0) {
不需要判断搜索词具体包含什么内容。无论关键词如何变化,只要查询结果为零,就会触发处理逻辑。
4. 设置真正的 404 状态
$wp_query->set_404();

status_header(404);
nocache_headers();
set_404() 用于将 WordPress 主查询标记为 404;status_header(404) 设置 HTTP 状态码;nocache_headers() 发送相应的缓存控制响应头。
这里不是简单地在页面上显示一段“没有找到内容”的文字,而是让服务器返回实际的 404 响应。
这段代码适用于标准 WordPress 主搜索查询。如果 Elementor 使用独立的自定义查询组件,或者网站通过自定义路由实现搜索,则需要先确认主查询是否代表实际展示的搜索结果。
此外,这种方法是在 WordPress 执行主查询后进行判断,不能节省本次查询已经产生的数据库开销。如果后续出现大量高频请求,还应考虑 Nginx 限流等措施。
对于搜索结果大于零的页面,如果不希望它们进入搜索引擎索引,可以使用 noindex 指令。
WordPress 网站可能通过 SEO 插件输出 robots 元标签。部署前应先检查页面源代码,避免重复添加。
如果网站尚未输出 noindex,可以在 Haozhuti Core 或主题的 functions.php 中添加以下代码:
/**
 * Haozhuti:禁止站内搜索结果页被搜索引擎收录
 */
add_filter('wp_robots', function ($robots) {
    if (is_search()) {
        $robots['noindex'] = true;
        $robots['follow']  = true;
    }

    return $robots;
});
noindex:告诉支持该指令的搜索引擎,不要将当前页面纳入搜索索引。follow:允许搜索引擎继续跟踪页面中的链接。这条规则只针对被 WordPress 识别为搜索页面的请求,不会直接禁止普通文章、产品详情页和企业介绍页面被收录。
如果网站已经通过 Yoast SEO、Rank Math 或其他 SEO 组件正确输出 noindex,则不必再重复添加此代码。
这三个机制经常被混淆,但它们的作用不同。
| 机制 | 主要作用 | 适用场景 |
|---|---|---|
| HTTP 404 | 告诉客户端当前请求的资源不存在 | 无搜索结果的搜索 URL |
noindex |
告诉支持该指令的搜索引擎不要收录当前页面 | 有结果但不希望被收录的搜索页面 |
robots.txt |
控制符合规则的爬虫是否允许抓取指定 URL | 控制抓取范围,而不是直接控制收录 |
对于本案例,不建议通过 robots.txt 禁止抓取所有搜索页面。
例如:
Disallow: /search/
Disallow: /*?s=
这种配置可能导致搜索引擎无法访问对应页面,从而无法读取页面中的 noindex 指令,也无法重新抓取并确认服务器返回的 404 状态。
更合理的做法是允许搜索引擎抓取这些 URL,再通过 HTTP 状态码和页面指令分别处理。
代码部署后,需要验证服务器实际返回的状态码,而不能仅凭浏览器中显示的页面内容判断。
使用以下命令检查:
curl -sS -o /dev/null -w '%{http_code}\n' \
'https://example.com/search/异常搜索词'
预期输出:
404
请将示例地址替换为自己网站的实际 URL。
选择一个确定能匹配站内文章或产品的搜索词,再执行相同的测试。
预期结果通常为:
200
如果正常搜索也返回 404,需要检查 WordPress 主查询、搜索范围以及主题的自定义搜索逻辑。
对于有搜索结果的页面,在浏览器中打开页面源代码,查找:
<meta name="robots" content="noindex, follow">
实际输出可能包含其他指令,例如图片预览设置。这并不一定是问题,关键是确认存在有效的 noindex。
如果网站使用 WP Rocket 或其他缓存组件,应检查搜索 URL 是否被缓存。
在已经排除搜索页面缓存的情况下,部署后可以直接进行验证。如果修改代码后仍然返回旧内容,则需要检查浏览器缓存、服务器缓存、反向代理缓存等环节。
注意,清除缓存并不能代替 HTTP 状态码验证。最终应以实际响应为准。
即使网站没有主动创建这些链接,外部提交、其他网站链接或爬虫探测也可能让搜索引擎发现它们。
需要区分两种情况。
保持当前处理逻辑即可:
noindex。一般不需要针对每个 URL 单独操作。
搜索引擎需要重新抓取页面,才能确认当前状态。
如果之前已收录的 URL 现在稳定返回 404,搜索引擎通常会逐步将其从索引中移除。
如果需要加快处理,可以使用相应搜索引擎站长平台提供的 URL 移除工具。此类工具通常用于临时加快隐藏过程,不能代替正确的服务器响应。
对于正常搜索结果页,即使已经输出 noindex,搜索引擎也需要重新抓取后才能识别该指令。因此,页面不会保证立即从已有索引中消失。
适合,但前提是 Elementor 页面使用的搜索结果确实由 WordPress 主查询控制。
Elementor 主要负责页面布局和内容展示。它可以使用标准 WordPress 查询,也可以通过 Loop Grid、Loop Carousel 或自定义查询展示内容。
如果搜索结果来自标准主查询,那么 is_search() 和 $wp_query->found_posts 通常可以满足需求。
如果使用独立的 Elementor 查询,则应先确认:
$wp_query。found_posts 是否与页面展示的结果数量一致。不能只因为 Elementor 页面显示了“No Results Found”,就认定 WordPress 主查询的 found_posts 必然为零。
针对 WordPress 网站被外部构造垃圾搜索 URL 的情况,可以建立以下规则:
noindex 避免进入搜索引擎索引。这套方法的优势是无需持续维护垃圾关键词黑名单,也不需要因为少量异常 URL 就引入复杂的安全插件。
对于使用 WordPress、Elementor 和常见 SEO 插件的企业网站,这是一种实现成本低、规则清晰、便于长期维护的基础治理方案。
需要强调的是,404 和 noindex 可以控制无效页面的响应及收录行为,但不能单独防止高频请求消耗服务器资源。如果后续出现明显的自动化高频访问,应再结合日志和 Nginx 限流进行处理。
本文由 好主题 原创整理,致力于分享实用的 WordPress 建站知识与主题开发经验。 我们专注于提供高质量的 WordPress企业主题 资源,帮助中小企业轻松构建专业网站。 转载请注明来源,并保留原文链接,感谢您的支持与理解。
联系我们
教程看不懂?联系我们免费为您解答!免费助力个人,小企站点!

成为会员,获得更多专属优惠!
登录您的账户,享受会员专属服务